为什么用Nezha探针
尽管Nezha爆出了惊天大漏洞(CVE-2026-53519),而且我也不喜欢“Nezha”这个名称,我仍然坚持使用哪吒作为探针。 我见过一些其他选择,但是由于各种原因,我都没有使用
| 选项 | 不使用原因 |
|---|---|
| Komari | 探针算法耍赖皮 |
| Beszel | 对tcp探针支持得似乎不大好 |
| blackbox + prometheus + grafana | 听着很麻烦,还没研究过 |
| … |
Komari“探针算法耍赖皮”
和nezha最相似的产品就是Komari了,在很多方面,他的开箱功能做得比Nezha更好,比如:
- 网络探针支持更精细的时间窗口
- 可以用于统计资产
- 没有爆出惊天大漏洞
- …总之还有很多…
但是唯一令我不满的的是,他的tcping探针算法非常诡异
- 首次测量如果超过 1000 ms,会再测最多 3 次;如果后续某次恢复到 1000 ms 以下,它会把最终结果替换成后面的较小值;
- 如果是 TCP 且“第一次值 - 第二次值 > 800 ms”,它还会把这次结果判定为“可疑重传”,直接当作失败上报
-1; - 如果连续都高于 1000 ms,则不保留高延迟值,而是同样转成失败。
换句话说,Komari 会把许多我本来想看到的高延迟尖峰,改写成更低延迟,或者改写成丢包/失败。这会显著减少图上的 spike。
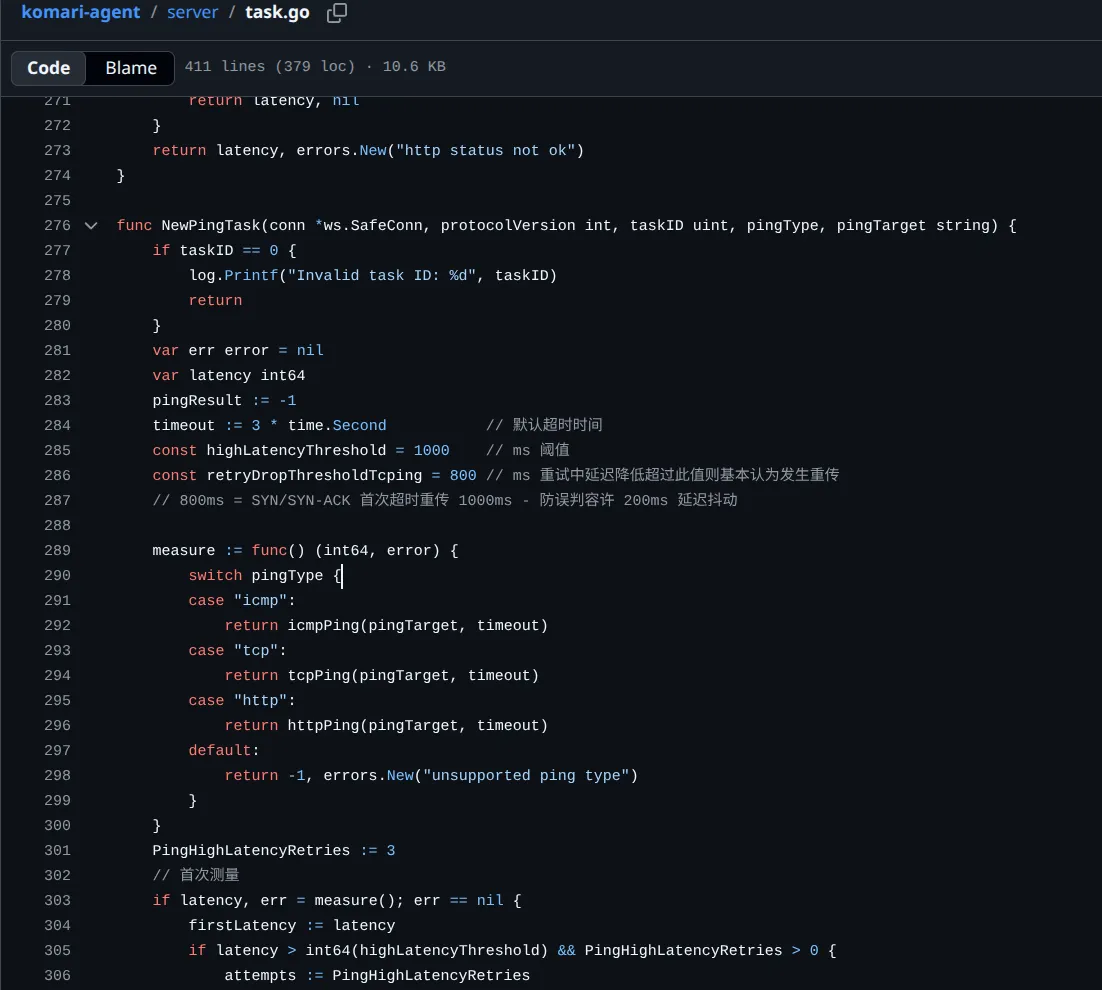
我觉得这完全是画蛇添足。愚以为,在网路上,tcp丢了就是丢了,超时了就是超时了;而Komari探针却认为这种丢包可能是测量误差,进而通过算法来人为降低丢包率,我实在搞不懂。
想象一下,如果每次采样都触发高延迟重测,而重测又测得低延迟结果。这条链路实际上是不大行的,但是画出来的探针图是一条线。这合理吗。。。
如果说未经komari算法过滤的裸TCPconnect可能会导致偏高的延迟,那Nezha 上面这种全天一条线的探针图为什么还存在呢?
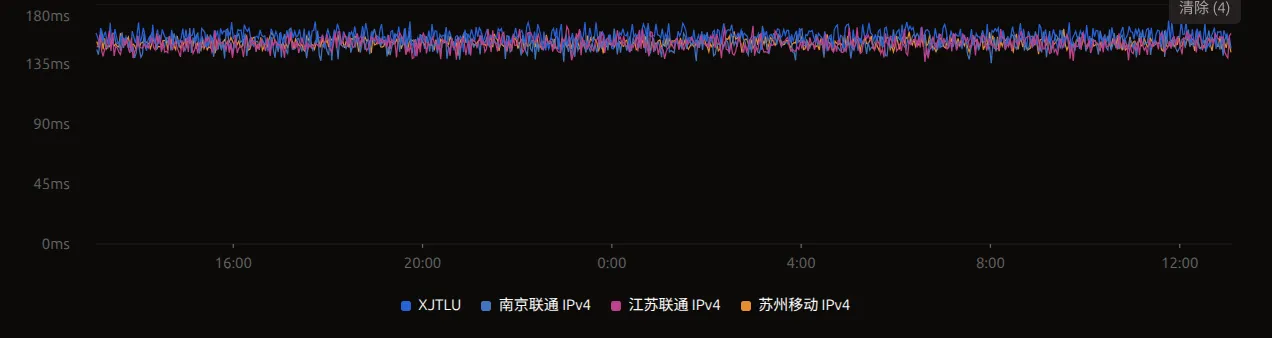
如果探针硬编码已经过滤了一次延迟尖峰,那么消峰功能是干什么用的呢?
总而言之,我认为Komari的探针无法忠实地展示真实的网络延迟情况。给人一种报喜不报忧,专挑好的说 的感觉。对于我这种线路机爱好者来说,网络质量的体现非常重要。这种诡异算法足以一票否决Komari。
安全使用Nezha
虽然改一下komari的探针算法也不是很难,不过我目前一直在用nezha,短时间也懒得迁移了。。。所以我还是在使用nezha。。。
之前Nezha漏洞刚出的时候,我也被陌生人攻击过,不过我已经更新过Nezha版本,所以他应该没有成功。哈哈。如下是他尝试渗透的日志。
[GIN] 2026/06/16 - 14:47:15 | 404 | 1.42ms    | 2602:ffe4:8:5287:a25b:4451:27b2:31f8 | GET "/dashboard../data/config.yaml"
[GIN] 2026/06/16 - 14:47:16 | 404 | 534.465µs | 2602:ffe4:8:5287:a25b:4451:27b2:31f8 | GET "/dashboard../data/config.yaml"
[GIN] 2026/06/16 - 14:47:17 | 404 | 365.277µs | 2602:ffe4:8:5287:a25b:4451:27b2:31f8 | GET "/dashboard../data/config.yaml"
探针由两部分组成,中心面板端和agent端。想要尽量安全的使用探针,需要分别加固这两侧。
- 对于中心面板端,愚以为,不要相信面板程序内置的鉴权门户,而是要在更底层的网关处加固权限,比如:如果使用了Cloudflare tunnel,那么就启用Access,或者配合自己的统一SSO网关。
- 对于agent端,愚的思路是,即使探针被渗透,也要尽可能限制其权限,想办法限制坏人挖矿,发包,破坏系统等常见恶意行为。所以我现在会在部署agent之前,多套一层限制脚本:install-agent-hardened.sh。这个脚本大约是给探针建立低权限账户,然后限制硬件资源。